【实验性需求】英文词组的分词快速输入设想方案
-
1 关于英文词组分词查询算法的设计思路
注:仅做为思路参考。
1.1 词库加载
1.1.1 现有部分不变
- 继续加载词库码表及相应的创建索引
- 不区分单词还是词组,词组的编码为由词库内置
1.1.2 增加词组的额外处理
- 当发现加载的词条包含空格时,认定为词组,做特殊处理。
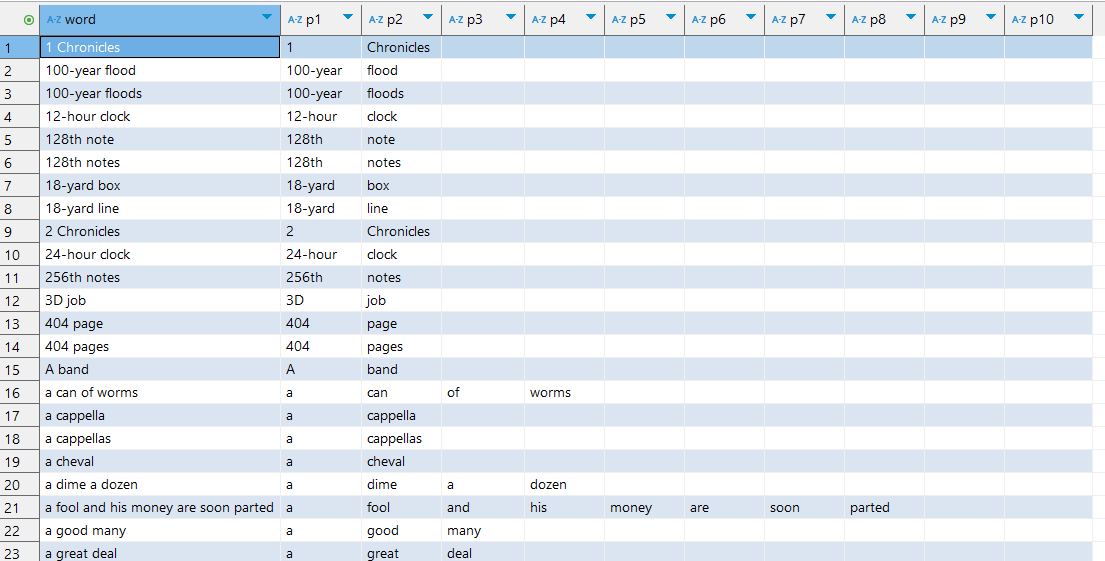
- 新设计一张tbl_phrases表,字段为:word,p1,p2,...p10, 共11个字段,word是词组原文,p1为word以空格分割后的第1个单词,p2为第2个...依次类推,词组只需要最多拆分到10个单词就够了,有些太长的有点扯。
- tbl_phrases表的各字段都要建立索引,注:很多词条可能后面的p3 - p10都是空的。
- 将拆分后的词组存入tbl_phrases表中,如果词组只有2个单词,则p3到p10字段填充空值。
- 词组数量并不会太多,经筛选,40W的词库里面,大概有2W条词组。
- 表结构示意:
1.2 单词输入时的查询
1.2.1 按分词方式查询词组
- 当用户输入的内容不包含分词符号时,按原逻辑进行筛选,只查询主表
- 当用户输入内容包含分词时,切换到查询词组表tbl_phrases
- 查询行为,以SQLite数据库为例(已导入2W词组), 查询目标词组为:
two heads are better than one - 输入分词方式:
two'he'a'be, 甚至不用输完,转成内部查询语句为:
SELECT word
FROM tbl_phrases
WHERE p1 LIKE 'two%'
  AND p2 LIKE 'he%'
  AND p3 LIKE 'a%'
  AND p4 LIKE 'be%';
注:这个查询操作即可命中词组,本机耗时约0.002秒。
- 哪怕按极端的,只输入第1个分词字母时,性能也很快:
SELECT word
FROM tbl_phrases
WHERE p1 LIKE 't%';
注:这个查询操作本机耗时也只约0.002秒。
1.3 后记
- 以上只是基于SQLite数据库的一些操作参考,清风输入法如果使用的内存库,则性能会更加优异。
-
验证结论:总体功能是OK的,还有个小问题。
- 输入英文词组分词的首字母,候选项里出现独立的单词
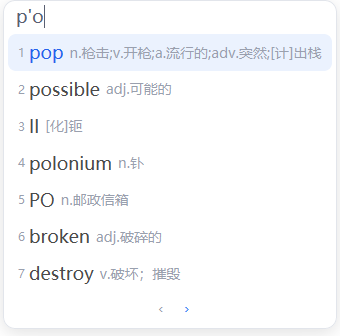
比如上图中
- 期望命中 plenty of
- 实际把很多单词也放到了候选项, 没有进入分词语义(只显示词组)。
- 输入英文词组分词的首字母,候选项里出现独立的单词
 需要考虑词组中本来就有“'”单引号的情况,如: