词语联想的两个问题:用户词库不可见 + 满码自动上屏不触发联想
给 WindInput 作者的问题报告与改进建议(可直接作为 issue / discussion 正文提交)
环境:WindInput v0.122.0(build 2026-09-20T01:31:34Z,git:a93e0de-dirty,release),Windows 10 IoT 企业版 LTSC 10.0.19044
方案:wubi86(五笔 86,最大码长 4),词库 = 极点主库 + extra + emoji + 行政区划(+ 用户自建的镜像库,见附录)
相关配置:[input.association] kind = "word"、mode = "continuous";[schema.codetable] auto_commit_at_full 在测试期间为 true(非出厂值,出厂 false)
日志:[debug] log_level = "debug" 下的实录,正文引用均为原文
摘要
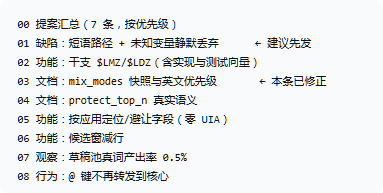
用户诉求只有一句:「词语联想也应该能联想我自己的词库」(原话参照:QQ 五笔可以)。实测下来是两条独立的问题叠加在一起:
#
问题
影响
性质
A
词语联想(以及其它消费反查索引的展示点)看不到用户词库与临时词
联想里永远没有用户自己的词
数据源覆盖范围问题,是否支持请作者定夺
B
满码唯一自动上屏(及同源的顶码上屏)不触发联想
开了自动上屏的五笔用户,单字上屏后永远没有联想
明确的接线缺口,建议修
两者叠加的用户可见现象就是「清风输入法的联想对我没用」。而 B 单独看更严重:五笔单字的全码绝大多数唯一 ⇒ 开自动上屏的用户,联想最主要的那个用法(打完一个字给以它开头的词)等于整个失效。
问题 B(先讲,因为它是 bug)
现象
操作
上屏路径
联想窗
打awsk(「荷」,全码唯一,开了满码自动上屏)
满码自动上屏
不出现
打awfa → 候选〔花卉 / 荷载〕→ 按空格选「荷载」
选词上屏
正常(3 条,全部来自用户词库)
日志证据(同一份配置、同一次运行)
选词上屏 —— 正常:
2026-09-20 12:19:00.738 DEBUG wind_coordinator::coordinator::message_handler: key_event: code=0x20 mods=0x0000 chinese=true full=false caps=false prev_char=0x0000 buf='awfa'
2026-09-20 12:19:00.741 DEBUG wind_coordinator::handle_assoc: 进入联想态 n=3 kind=Word mode=Continuous
自动上屏 —— 整段没有任何 handle_assoc 输出(maybe_enter_assoc 的三个静默 early-return 一个都没进):
(打 awsk 的整个时段只有 caret_update / 组合矩形 / 候选窗相关日志,无 handle_assoc 行)
把 auto_commit_at_full 关掉之后,同一个键序立刻通了:
2026-09-20 12:24:41.550 DEBUG ... key_event: code=0x20 mods=0x0000 ... buf='awsk' ← 第 4 键后按空格,不再自动上屏
2026-09-20 12:24:41.552 DEBUG wind_coordinator::handle_assoc: 进入联想态 n=9 kind=Word mode=Continuous
2026-09-20 12:24:42.579 DEBUG ... key_event: code=0x20 ... prev_char=0x8377 buf='' ← 空格选中「荷载」
2026-09-20 12:24:42.579 DEBUG wind_coordinator::handle_assoc: 进入联想态 n=3 kind=Word mode=Continuous
(n=9 那次的首条正是「荷载」,n=3 那次是「荷载取值 / 荷载效应 / 荷载组合」。)
定位
联想的触发点被刻意放在 commit_selected,docs/design/association.md §3.1 原文:
commit_selected 的整串分支是六类选词触发的唯一汇合处(空格 / 数字键 / 次三选键 / 修饰键选词 / 鼠标点选 / 数字键越界 overflow)
而满码自动上屏(以及顶码上屏)走的是另一条路——wind_input/crates/wind-coordinator/src/handle_candidate.rs 里的 InputOutcome::AutoCommit:
位置(v0.122.0)
内容
L1068
let auto_commit = if result.should_commit && !result.commit_text.is_empty() {
L1521–1523
`let auto_commit = auto_commit.or_else( |
L1528
let outcome = match auto_commit {
L1563
InputOutcome::AutoCommit(c.text.clone())
L1648
Some(InputOutcome::AutoCommit(c.text.clone()))(短语侧 phrase_auto_commit)
L1690(注释)
「顶码与全码自动上屏两条路径共用它——两者都是「引擎替用户做主上屏」」
旁证:整份 handle_candidate.rs(351 KB)里 assoc 出现 0 次——联想根本没有接在这条路上。
影响面
受影响人群 = 所有开了 schema.codetable.auto_commit_at_full 的码表用户(本机就是;该值是用户配置里手动开的,出厂 false)。
五笔单字全码绝大多数唯一 ⇒ 单字几乎必然走自动上屏 ⇒ 「打完『中』给『中国』」这个词语联想最核心的用法在他们那里完全不可用,而且完全静默:没有日志、没有提示,用户只会认为联想功能坏了。
顶码上屏(top_code_commit,出厂就是 true)与自动上屏同源(见上表 L1690),推测同样不触发联想——这条没实测,请作者确认。
建议修法(供参考)
最省事:让自动上屏复用 commit_selected 的整串分支,或在 InputOutcome::AutoCommit 真正提交文本的那一处,调用与 commit_selected 末尾同一段联想接线。
️ 关键是状态形状:联想态要求「缓冲已清空 + state.active = None + 无已转换段」,而自动上屏发生在「缓冲非空 + 引擎仍 active」的时刻。commit_selected 的整串分支本来就把这三件事都做完了,所以走同一条收敛路径能省掉一整类边界。
联想取的「上文」应是实际提交给宿主的文本(含简繁转换、英文补空格之后)——与 commit_selected 取 out 而非 final_simplified 的理由一致。
兼容性:自动上屏用户多为盲打型五笔用户,突然每次上屏都弹联想、且联想态占用数字键与空格(space_commits),行为变化很突兀(这也是桌面默认关联想的原因)。建议至少给一个显式开关,例如 [input.association] after_auto_commit = false(默认关,不改变既有用户行为),而不是无条件接上。
测试:handle_assoc::wiring_tests 里加一条「自动上屏后进联想态」的断言,从 handle_key_event 进(与既有接线测试同层)。注意 headless 下两处坑:不调 prewarm_indexes() 拿不到联想(索引没就绪就返回空)、不调 debug_mark_coords_ready() 拿不到 UI 通道。
问题 A:反查索引不含用户词库与临时词
现象
用户把自己常用的专业词(幕墙/荷载一类)上屏过很多次,userdata.redb 里也确实有(dict export 能导出),但联想里永远不出现这些词——无论上文是单字还是词。
原因(据代码)
反查索引(.wridx)只由「启用的 .dict.yaml 词库」构建(load_dicts_individually 那条路),每个方案一份,键是「词 → 编码」。
用户词库与临时词存在 userdata.redb 里,是引擎的 store 层,不参与索引构建。
于是所有 reverse_index_if_ready 的消费点都看不到它们:词语联想(assoc_prefix_words)、候选注释里的 ${code_all}(联想态下 code_hint 为空,正好显示的是它)、悬停 [编码] 段。
顺带一问:manager.rs::reverse_index_for 的注释说加词去重校验也用它(「那里返回空表会导致重复加词,是正确性问题」)——那么用户词在这个校验里同样不可见,是否会造成用户词与用户词/词库词之间的去重漏判,请作者判断。
我的验证方式
对 %LOCALAPPDATA%\WindInput\cache\wubi86\wubi86.wridx 做原始字节搜索:
词
镜像进.dict.yaml 之前
之后
基础验收 / 幕墙节能 / 工厂化加工 / 散索鞍
搜不到
搜得到
即:同一个词,只要不进 .dict.yaml,联想就取不到它。
建议(供作者取舍)
联想取数时叠加引擎层的用户词(前缀查询 + 权重合成),或在索引构建时把 store 层用户词/临时词一并并入(后者对 ${code_all}、悬停编码也一并生效,但索引需要随用户词变化增量更新,代价更大)。
若结论是「用户词不参与词语联想」是有意设计,也建议在文档里写明,免得用户像我这样绕一大圈。
附录:本机的规避方案与实测数据(供作者参考,不需要上游采纳)
规避 A:把用户词库/临时词镜像成一本普通 .dict.yaml(dict export → 生成码表 → 作为 extra 词库挂进方案),这样它们就进了反查索引。已装:2033 条 / 1993 键,索引规模 91126 词(5 本词库)。
规避 B:镜像后有个副作用——新词的权重取的是码表文件权重,而系统词库的权重是真实词频(工 9999、工艺 1717…),用户词以权重 0 参与排序会被挤到第 88 位之后,等于看不见。实测把用户词权重统一抬到 1900:
上文
修前
修后
工
前 9 条全是系统词
工作 / 工具 / 工资 之后全是用户词(第 4 名起)
基
前 9 条全是系统词
基本 / 基础 / 基金 / 基于 之后全是用户词
荷载(2 字词)
竞争少,本来就能出
全部用户词
抬权重的代价也量化过(1993 个码位):689 个用户码位与系统词重码、812 个系统词被挤到后面、650 个码位用户词成为首选;1304 个码位没有系统竞争对手,正常打字零影响。
规避 C(问题 B):把 auto_commit_at_full 关回出厂 false,换回联想——代价是满码后要多按一次空格。这只是规避:本该由输入法同时提供的两件事,被迫二选一。
复现清单(最小步骤)
方案 wubi86,配置 [input.association] kind = "word",[debug] log_level = "debug"。
问题 B:[schema.codetable] auto_commit_at_full = true → 打 awsk(荷,满码唯一)→ 上屏成功但日志无 handle_assoc;改成 false → 打 awsk + 空格 → 出现 进入联想态 n=9。
问题 A:对任意曾经上屏过的用户词(例如两个字以上、系统词库里没有的),确认 dict export 里有它,再打它的首字上屏 → 联想的候选里不会有它;把它写进 .dict.yaml 后立刻出现。